如果一个AI每10分钟就要你回来看一眼,它当然有用。但它还称不是上是真正的劳动力。
过去国产模型和海外顶级模型之间最明显的体验差距,其实不在“会不会写代码”。很多模型都能写代码,都能补函数,都能改页面。真正的差距在另一个地方:你能不能把一个复杂任务交给它,然后走开。
这就是CodingAgent的代际差。一个需要人类持续盯着、不断拆任务、不断纠偏的模型,本质上还是一个很聪明的实习生。而可靠性,从某种程度上才代表了CodingAgent真正的智力水平。
所以今天Qwen3.8的发布,最值得看的不是2.4万亿参数,也不是某个单点benchmark又涨了几分。而是它试图补上这个代际差:国产模型也开始从“会写代码”,走向“能交付任务”。
我们认为这背后是大模型竞赛计量单位的变化。过去大家比的是一次生成的质量,这一题答得准不准,这段代码写得好不好。
但Agent时代,真正的计量单位:Agent究竟能帮人节省多少时间。
所以CodingAgent的智力,正在越来越多地体现为长程任务能力。它不只是“智能”本身,而是智能×可靠性的乘积。单步推理再强,如果第20轮开始忘目标,第50轮开始乱改文件,第100轮无法解释自己做过什么,它就仍然不能被托付。
一旦跨过端到端交付这道门槛,AI才有机会从“效率工具预算”进入“企业级项目预算”,这中间差的不是几个百分点的模型分数,而是两个数量级的市场空间。
Qwen3.8这次要讲的,正是这个变化:模型不再只是代码生成器,而开始接近一个可以被长期托付的执行主体。
长程任务跑分:Qwen3.8-Max真的可交付
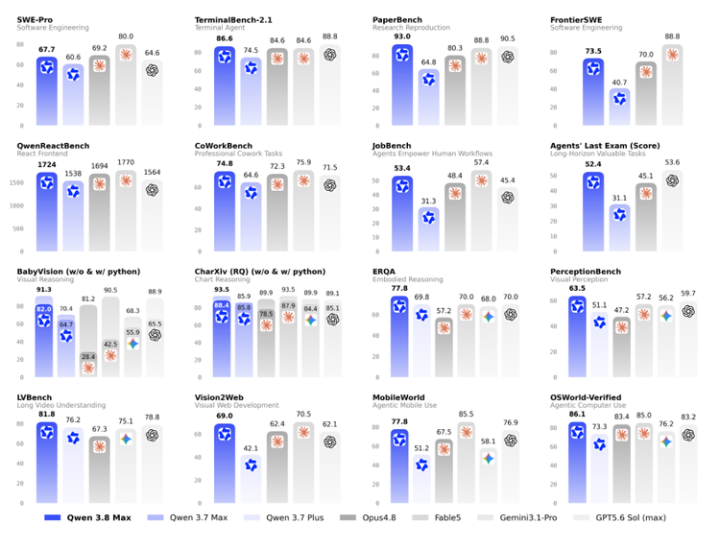
从官方技术博客给出的信息看,Qwen3.8-Max在传统能力上补齐了很多指标:总参数量2.4万亿,激活参数95B,支持1MTokens上下文和视觉理解。
在基础的TextArena文本能力榜单和VisionArena视觉能力榜单中,覆盖数学、代码、创意写作等开放式文本任务,以及编程能力(前端)等核心能力项目中,Qwen3.8-Max均仅次于Anthropic系列。文本能力是长程任务的前提,模型要在复杂上下文里持续理解目标、更新计划、吸收反馈,文本底座不够强,Agent很快就会在需求理解上跑偏。
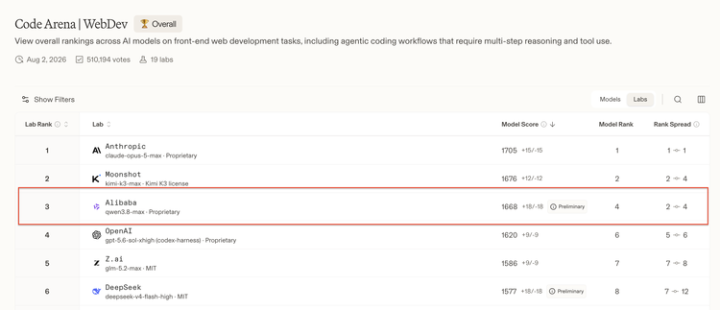
在前端设计上,CodeArena这个榜单考察的不是「写对一个函数」,而是多步骤推理加工具调用的agenticcodingworkflow:理解页面结构、生成前端代码、处理交互状态、调用工具、看结果、继续改。会写代码的模型很多,能在一个工程里持续工作、不断修正、最终交付的模型很少。目前来看,Qwen3.8-Max低于Opus5-max和以前端Coding为核心能力的K3。
但这些榜单验证的是某一个环节的基础排名和单点能力,硅星人更想了解的是在真实的交付环境下,Qwen3.8-Max能否完整地交付。
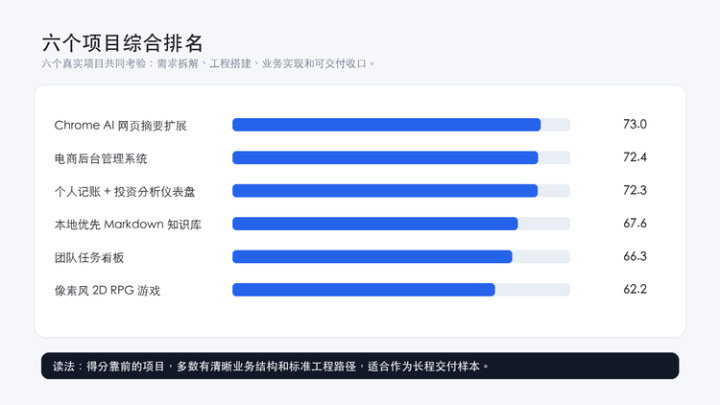
为此,硅星人建立了「AgentLong-TaskBenchmark」测试集,不是让模型写一个函数或答一道算法题,而是让它完成六个完整项目:本地优先Markdown知识库、个人记账和投资分析仪表盘、电商后台管理系统、团队任务看板、像素风2DRPG游戏、ChromeAI网页摘要扩展。
这些任务的共同特点是,都不是「一次生成」能解决的。它们需要模型自己做需求拆解、项目初始化、技术栈搭建、数据库设计、前端交互、业务逻辑、测试、构建、部署和证据留存,更像一个工程师连续干几天的活,而不是聊天框里的一次demo。
评分拆成两部分:功能完成度占70%,证据、可交付性、可复现性占30%。前者看模型能不能把主体功能做出来,后者看它能不能证明这个东西真的能运行、能部署、能复现、能被验收。
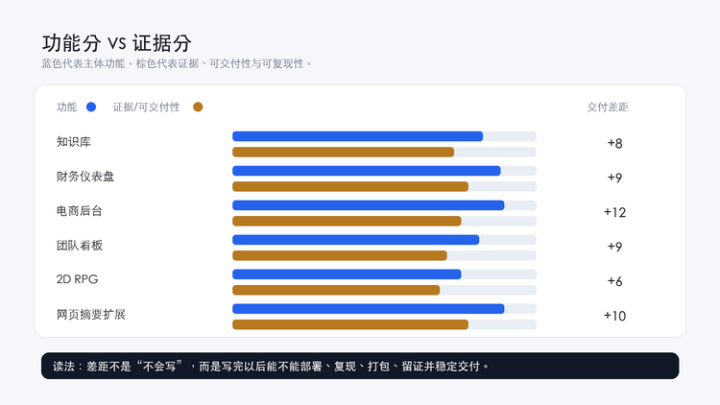
第二项之所以重要,是因为很多Agent的问题不是「不会写」,而是「写完之后没人敢交」。页面看起来有了,但还需要运行数据,代码生成后进入测试阶段,功能实现之后的日志输出和构建产物,这些都是真实场景下需要衡量的数据标准。
从结果来看,Qwen3.8-Max能比较快地完成项目初始化、技术栈选择、基础页面搭建、CRUD结构、LLM应用流程和数据看板等工作。换句话说,Qwen3.8-Max已经不是只能写单个函数或生成孤立页面,而是能把一个需求先变成一个可以继续开发的项目骨架。
这一点,在表现最稳的Chrome扩展、电商后台、记账仪表盘三个任务里表现得尤其明显,这几个任务有明确的业务结构和相对标准化的工程路径。比如电商后台,在第一轮静态自查中已经完成了登录鉴权链路、路由保护、seed管理员账号机制和后台基础框架。不是简单写了一个登录页,而是把后台系统的入口能力搭了起来。模型已经能从「代码片段」推进到「项目骨架」。
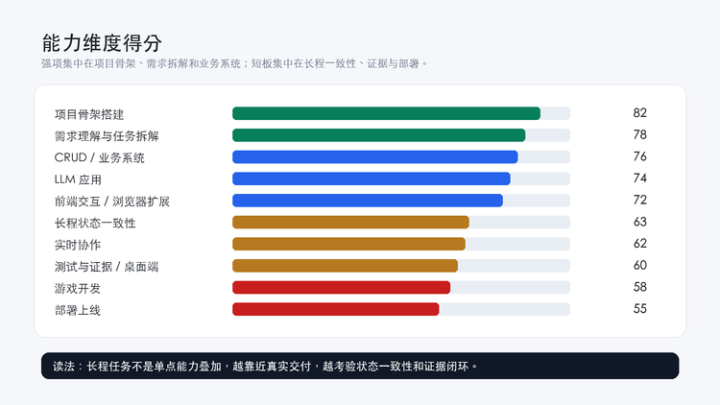
更重要的是,模型开始具备一定的“交付意识”。它不只是生成代码,还会围绕登录鉴权、路由保护、seed数据、后台框架、构建路径这些真实项目里必须存在的环节推进任务。这说明Qwen3.8-Max的Coding能力已经从“代码补全”往“工程搭建”前进了一步。
当然,长程任务真正难的部分仍然在后半程:部署、复现、证据留存、实时状态同步、复杂状态机和多轮交互稳定性。这些也是目前拖分最明显的地方。但这恰好说明,长程Benchmark的价值不在于给模型一个漂亮总分,而在于把“会写”和“能交付”之间的距离量出来。
所以,如果用一句话概括这次测试:Qwen3.8-Max已经在结构化工程任务里表现出可托付雏形,尤其擅长把复杂需求拆成项目骨架并完成主体功能;它离完全生产级交付还需要补齐证据闭环和长程状态一致性,但交付能力的差距正在缩小。
16天长程无人干预,不是Qwen3.8-Max的极限
那么长程任务到底能有多长?
在Qwen3.8-Max的技术博客里,有一个让我们没有想到的案例:oh-my-cli。这个项目由Qwen3.8-Max自主运行了16天,无人持续监管。时间单位已经完全脱离了按分钟、小时计算的范畴,而是按天甚至是按周计算。
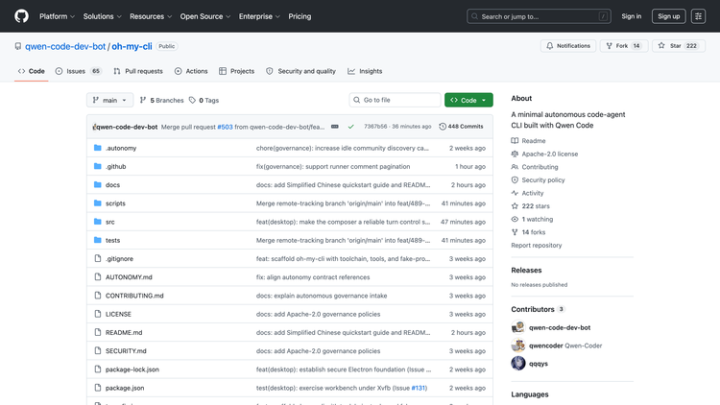
用户只给出一句「创建一个自进化的智能体Harness」,模型从空文件夹出发,自主搭建LoopEngineering框架,编排智能体自动领取和执行任务。它把用户反馈、社区实践和模型自测结果纳入工程循环,将需求规范化为issue,再由agent自动领取、执行、测试、修复、继续迭代。
这个过程持续了16天。最终交付出一个真实可用的自进化智能体框架,项目完全开源,完整过程保存在GitHub仓库,可查代码、commit、PR和issue。
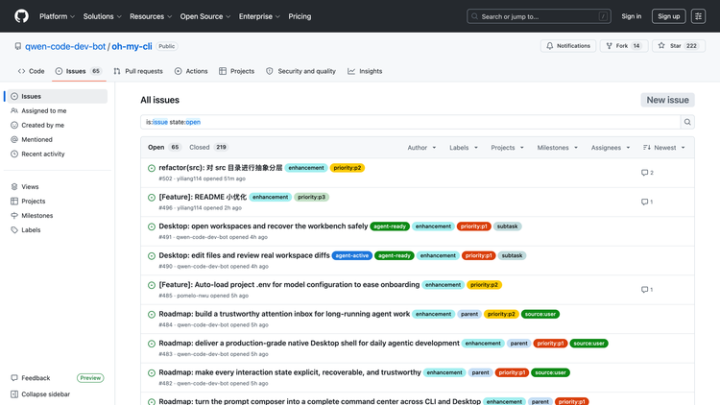
今天很多模型都能写CLI,也能写一个demo级的agentwrapper。oh-my-cli真正值得讨论的地方在于,它不是一次生成出来的,是在一个无人持续介入的长程过程中被模型一点点推进出来的。
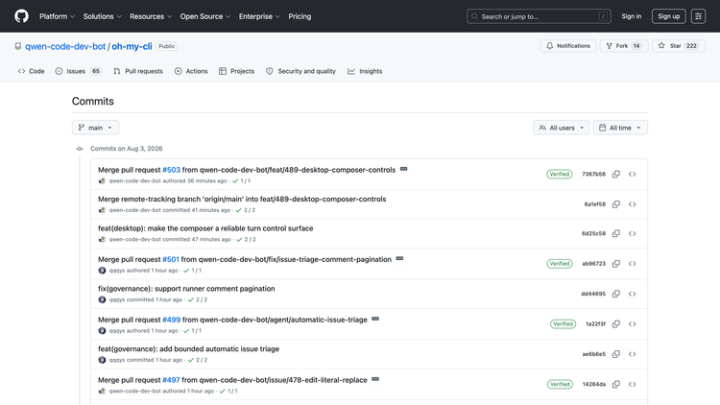
它要先理解「自进化智能体Harness」意味着什么,然后设计项目结构,处理命令行交互、会话管理、恢复、压缩、审批、工具调用、MCP、工作区隔离、undo/redo、headlessprotocol、handoff等一整套Agentruntime问题。更重要的是,它要在持续反馈中不断修正自己。
模型要把工程任务变成一个持续循环:需求进入系统转成issue,issue拆解成任务,任务变成代码,代码进入测试和反馈,反馈再变成下一轮行动。
一个成熟工程师不只会写函数,更知道如何围绕目标组织行动:搭骨架、填模块、遇到报错定位、测试失败回滚、需求变化调整计划、最后留下能被别人接手的证据。oh-my-cli的意义,是它把Qwen3.8-Max的能力从「会写代码」推到了「会组织工程过程」。
但光能干活还不够。谈「放手让模型干活」的时候,硅星人认为还有一个必须被回应的问题:成本。
有时候并不是模型做不到,而是人处于成本考量不敢放手让模型自进化。长程任务不是一次调用成本,而是一段过程成本。
根据彭博社的对比,Qwen3.8-Max输入$2/MTokens、输出$6/MTokens,Qwen3.8-Max的输出价格是GPT-5.6Sol的五分之一,是Fable5的八分之一。
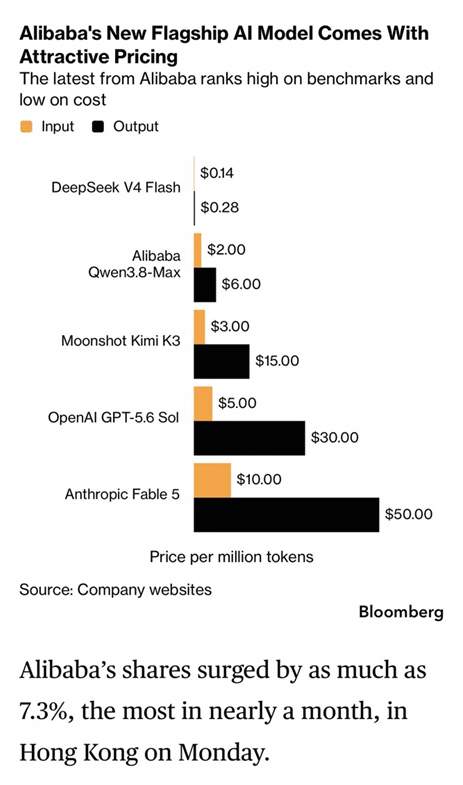
在短任务中成本差距并不明显,但长程任务会把价格差距放大到不可忽视的程度。一个Agent连续工作16天,背后可能是几十万次Token消耗。按Fable5的定价,一个项目的模型成本可能达到几百甚至上千美元;按Qwen3.8-Max的定价,同样的任务量成本降到十分之一以内。
当模型既能做到长时间无人干预地推进任务,成本又控制在企业可接受的范围内时,它才能真正产生生产价值:不是「有用的工具」,而是可以被排进项目计划里的生产力。
结语
在Qwen3.8的官方博客里,已经能看到这种生产力正在落地:头部智能体平台用它搭建大规模Agent系统;开发者让它承担高强度工程任务;科研团队用它跑通「文献—数据—仿真」的完整研究闭环;白领工作者把图片、手稿、视频等繁杂材料一次性交给它处理。同一个模型,在不同领域、不同工作流中被反复用到「离不开」。
能力信任和价格信任同时成立的时候,CodingAgent才真正从demo进入生产。
天载配资提示:文章来自网络,不代表本站观点。